什么是 QR 码
QR 码(Quick Response Code)由日本电装公司(DENSO WAVE)于 1994 年发明,最初用于汽车零部件的追踪管理。与传统一维条形码只能存储十几个字符不同,QR 码可以存储最多 7,089 个数字或 4,296 个字母数字字符,信息密度高出数十倍。
如今 QR 码已广泛应用于移动支付、网址跳转、身份验证、物流追踪等场景,成为连接线下与线上世界的重要桥梁。
QR 码的基本结构
QR 码(Quick Response Code)由日本电装公司(DENSO WAVE)于 1994 年发明,最初用于汽车零部件的追踪管理。与传统一维条形码只能存储十几个字符不同,QR 码可以存储最多 7,089 个数字或 4,296 个字母数字字符,信息密度高出数十倍。
如今 QR 码已广泛应用于移动支付、网址跳转、身份验证、物流追踪等场景,成为连接线下与线上世界的重要桥梁。
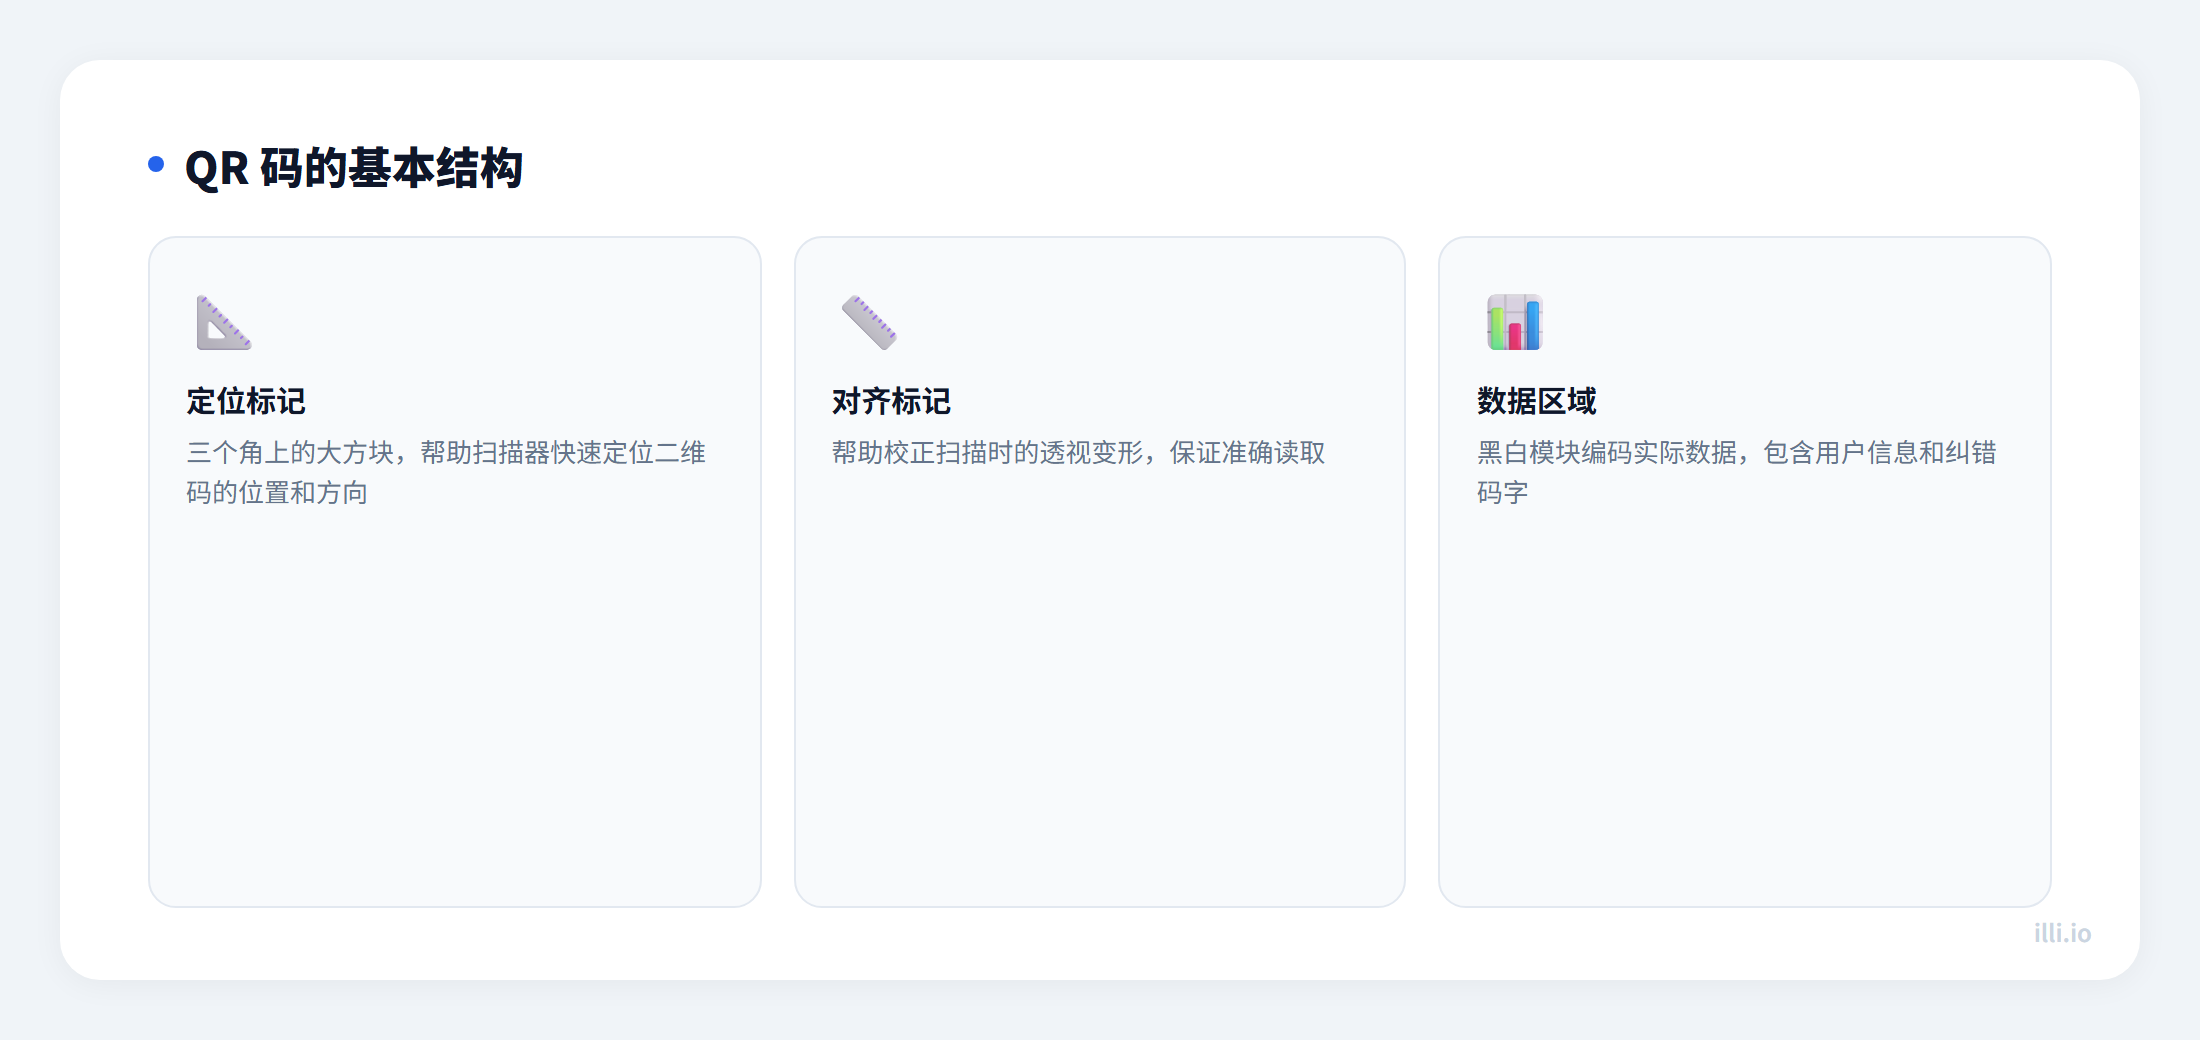
一个标准的 QR 码由以下几个核心区域组成:
QR 码的三个角各有一个由嵌套方块组成的大型正方形图案。扫描器通过这三个定位图案快速确定 QR 码的位置、大小和倾斜角度。这也是为什么 QR 码可以在任意角度被识别 — 扫描器检测到三个定位图案后即可确定坐标系。
在版本 2 及以上的 QR 码中,会出现较小的对齐图案(一个小正方形嵌套)。它们帮助修正扫描时因曲面或透视变形产生的畸变。版本越高,对齐图案越多。
连接三个定位图案之间的交替黑白模块行/列,帮助扫描器确定每个模块的精确坐标位置。
存储当前 QR 码使用的容错等级和掩码图案信息,位于定位图案周围的固定位置。
QR 码的主体区域,存储实际编码数据和 Reed-Solomon 纠错码字。
QR 码将输入数据转换为二进制位流的过程分为以下步骤:
QR 码支持四种编码模式:
根据选定模式将原始数据编码为二进制位流,并在头部添加模式指示符和字符计数信息。
使用 Reed-Solomon 算法对数据码字生成纠错码字,将两者交织排列后填入 QR 码矩阵。
为避免出现大面积的纯黑或纯白区域(影响扫描识别),QR 码会对数据区域应用 8 种掩码图案之一,选择得分最优的掩码方案。
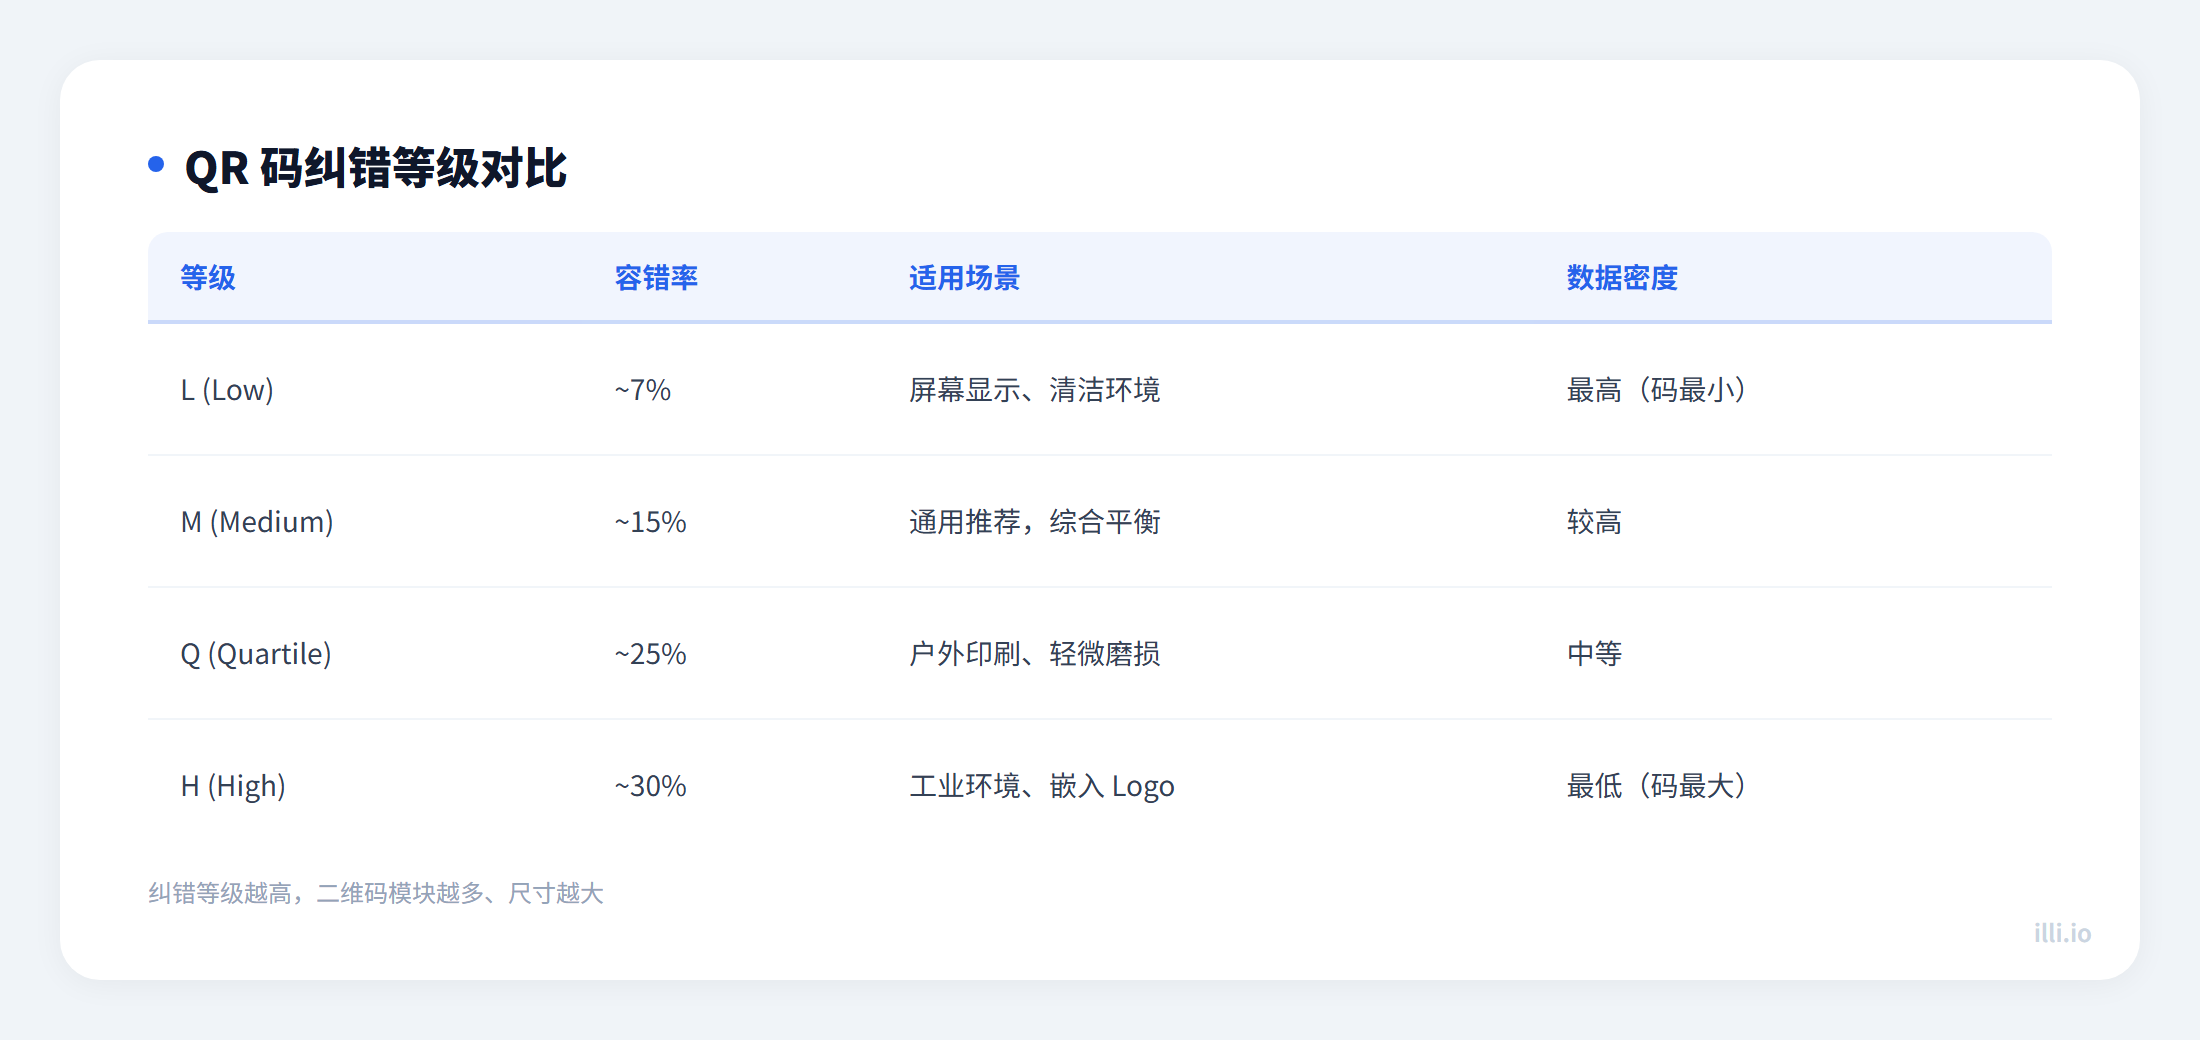
QR 码最核心的优势之一是其容错能力 — 即使部分区域被遮挡、磨损或污染,仍然可以被正确识别。这依赖于 Reed-Solomon 纠错算法。
| 等级 | 纠错能力 | 数据恢复比例 | 适用场景 |
|---|---|---|---|
| L(Low) | 低 | 约 7% 数据可恢复 | 数据量大、干净环境 |
| M(Medium) | 中 | 约 15% 数据可恢复 | 通用场景(默认推荐) |
| Q(Quartile) | 较高 | 约 25% 数据可恢复 | 可能被部分遮挡 |
| H(High) | 高 | 约 30% 数据可恢复 | 恶劣环境、需要嵌入 Logo |
容错等级越高,QR 码中用于纠错的码字比例越大,留给实际数据的空间就越少。这意味着:
例如,Version 1(21×21 模块)在 L 等级下可存储 41 个数字,而在 H 等级下仅能存储 17 个数字。
这正是容错机制的典型应用。将 Logo 放置在 QR 码中央,相当于"破坏"了该区域的数据模块。只要被遮挡的面积不超过当前容错等级的恢复上限,扫描器仍然可以通过纠错码字还原完整数据。这就是为什么嵌入 Logo 的 QR 码通常使用 H 等级容错。
QR 码从 Version 1(21×21 模块)到 Version 40(177×177 模块),共有 40 个版本。每增加一个版本,矩阵每边增加 4 个模块。版本越高,可存储的数据越多,但 QR 码的物理尺寸也需要相应增大以保证扫描可靠性。
实际应用中,大多数 QR 码使用 Version 1 到 Version 10(21×21 至 57×57),完全可以满足 URL、文本、名片等常见数据的编码需求。
QR 码的技术设计兼顾了信息密度、读取速度和容错能力。三点定位图案实现了多角度快速识别,Reed-Solomon 纠错算法确保了数据在部分损坏时仍可恢复,而灵活的编码模式和版本选择让 QR 码能够适应从几个字符到几千字符的不同需求。理解这些底层原理,可以帮助你在生成 QR 码时做出更合理的参数选择。